چکیده
واریانتهای (گونههای) ژنتیکی خطرناک برای بیماریهای شایع عمدتاً در مناطق تنظیمی غیرکدکننده قرار دارند و بیان ژن را تعدیل میکنند. اگرچه مطالعات بافت تودهای مکانیسمهای مشترک ژنتیک تنظیمی و مرتبط با بیماری را روشن کردهاند، اما اختصاصی بودن سلولی این مکانیسمها تا حد زیادی ناشناخته باقی مانده است. در اینجا، ما یک اطلس جامع، چندتباری و تکهستهای از تنظیم ژنتیکی بیان ژن در قشر پیشپیشانی انسان را ارائه میدهیم که شامل ۵.۶ میلیون هسته از ۱,۳۸۴ اهداکننده با تبارهای متنوع است. از طریق تجزیه و تحلیلهای چندرزولوشنی که هشت رده اصلی سلولی و ۲۷ زیررده را در بر میگیرد، تنظیم ژنتیکی را برای ۱۴,۲۵۸ ژن شناسایی میکنیم که ۹۸۱ مورد آن اثرات تنظیمی خاص نوع سلول را در سطح رده و ۸۵۷ مورد در سطح زیررده نشان میدهند. همجایگزینی واریانتهای ژنتیکی مرتبط با تنظیم ژن و ویژگیهای بیماری، ژنهای جدید خاص نوع سلول را که در بیماری آلزایمر، اسکیزوفرنی و سایر اختلالات نقش دارند و در تجزیه و تحلیلهای بافت تودهای قابل تشخیص نبودند، آشکار میکند. تجزیه و تحلیل تنظیم ژنتیکی پویا در سطح تکهستهای، ۲,۰۷۳ ژن را با اثرات تنظیمی که در طول مسیرهای تکاملی، که از طیف وسیعی از سنین اهداکنندگان استنباط شده است، تغییر میکنند، شناسایی میکند. ما همچنین ۱,۶۵۵ ژن را با اثرات تنظیمی ترانس (trans-regulatory effects) کشف میکنیم که تنظیم دوردست بیان ژن را نشان میدهد. این اطلس با وضوح بالا، بینشی را در مورد معماری تنظیمی خاص نوع سلول مغز انسان فراهم میکند و اهداف مکانیکی جدیدی را برای درک مبنای ژنتیکی بیماریهای عصبروانپزشکی و نورودژنراتیو ارائه میدهد.
مقدمه
مغز انسان از مجموعهای از انواع سلولها با طیف وسیعی از عملکردهای بیولوژیکی، تعاملات سلولی و مشارکتهای منحصر به فرد در خطر ژنتیکی برای ویژگیهای نورودژنراتیو و عصبروانپزشکی تشکیل شده است. واریانتهای ژنتیکی خطرناک که توسط مطالعات انجمن سراسر ژنوم (GWAS) در مقیاس بزرگ شناسایی شدهاند، عمدتاً در مناطق غیرکدکننده قرار دارند و نقش تنظیمی در تغییر بیان ژن ایفا میکنند. درک نقش اثرات تنظیمی مشترک و خطر بیماری در بافت تودهای، بینش جدیدی را در مورد ژنها و مکانیسمهای مولکولی زیربنای زیستشناسی بیماری به ارمغان آورده است. با این حال، تجزیه و تحلیل بافت تودهای نمیتواند اثرات تنظیمی ژنتیکی را که در میان انواع مختلف سلولها متفاوت است، بررسی کند و نقش متمایز این انواع سلولها را در زیستشناسی بیماری نادیده میگیرد. تلاشهای اخیر برای افزایش وضوح نوع سلولی اطلسهای تنظیمی ژنتیکی با استفاده از مرتبسازی سلولی یا استنباط بیان ژن بر اساس پانلهای مرجع تکسلولی، بهبودهایی را به ویژه برای انواع سلولهای رایج ارائه کرده است.
.
پیشرفتها در توالییابی RNA تکسلولی و تکهستهای (RNA-seq) امکان جمعآوری پروفایلهای رونویسی انواع مختلف سلولها را فراهم کرده و یک استراتژی بیطرفانه برای مطالعه واریانتهای تنظیمی ژنتیکی مؤثر بر بیان ژن در هر نوع سلول ارائه میدهد. تجزیه و تحلیلهای اخیر تنظیم ژنتیکی در دادههای ترانسکریپتوم تکهستهای از بافت مغز انسان پس از مرگ، اثرات تنظیمی ژنتیکی را برای ردههای وسیع سلولی، و همچنین ژنها، انواع سلولها و فرآیندهای مولکولی دخیل در زیستشناسی ویژگیهای مرتبط با مغز شناسایی کرده است. با این حال، ساخت یک اطلس تنظیمی ژنتیکی با اندازه نمونه بزرگتر، تنوع ژنتیکی بیشتر، تعداد هستههای بیشتر و خوانشهای RNA-seq بیشتر میتواند قدرت آماری، وضوح سلولی و پوشش انواع سلولهای نادر با نقشهای کلیدی در زیستشناسی بیماری را افزایش دهد.
.
در این کار، ما ۵.۶ میلیون هسته را از قشر پیشپیشانی دورسولترال (DLPFC) انسان از مجموعهای از ۱,۳۸۴ اهداکننده با تنوع ژنتیکی از مجموعه داده کامل PsychAD جمعآوری کردیم که ۳۵.۶ درصد از آنها از تبار غیراروپایی بودند. ما تجزیه و تحلیلهای تنظیمی ژنتیکی را در دو وضوح سلولی انجام دادیم، با هستههایی که به هشت رده سلولی و ۲۷ زیررده تقسیم شدند. ادغام اطلس تنظیمی ما با واریانتهای خطر بیماری با استفاده از تجزیه و تحلیلهای همجایگزینی، انواع سلولها و ژنهای زیربنای زیستشناسی بیماری ویژگیهای مرتبط با مغز را شناسایی میکند. تجزیه و تحلیل اثرات تنظیمی ترانس (trans-regulatory effects) و اثرات تنظیمی پویا که در طول یک مسیر تکاملی تغییر میکنند، بینش بیشتری را در مورد پیچیدگی معماری ژنتیکی بیان ژن ارائه میدهد. این اطلس تنظیمی ژنتیکی چندرزولوشنی بیان ژن در مغز انسان، درک ما را از مکانیسمهای مولکولی مؤثر بر بیان ژن و خطر بیماری بهبود میبخشد.
تنظیم ژنتیکی بیان ژن در مغز انسان
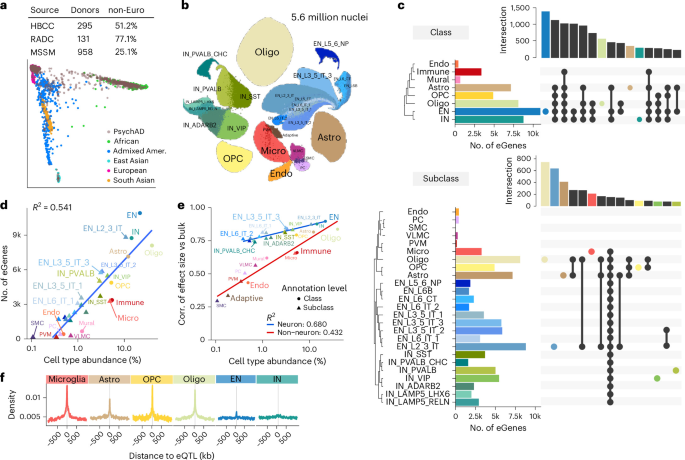
برای توصیف تنظیم ژنتیکی بیان ژن در انواع سلولهای مغز انسان، ما نمونههای بافت DLPFC پس از مرگ را از سه بانک مغز به دست آوردیم تا مجموعهای از ۱,۳۸۴ اهداکننده با تنوع ژنتیکی با دادههای ژنوتیپ از مجموعه داده کامل PsychAD ایجاد کنیم که ۴۹۳ مورد (۳۵.۶%) از آنها از تبار غیراروپایی بودند (شکل ۱ الف و شکل تکمیلی ۱). توالییابی RNA تکهستهای (snRNA-seq) بر روی بافت پس از مرگ انجام شد که پس از کنترل کیفیت، ۵.۶ میلیون هسته را به دست آورد و هستهها به هشت رده سلولی و ۲۷ زیررده تقسیم شدند (شکل ۱ ب). تجزیه و تحلیل واریانتهای ژنتیکی در فاصله ۱ مگابایت از محل شروع رونویسی، جایگاههای صفت کمی بیان (eQTLs) را در سطح رده و زیررده شناسایی کرد (شکل ۱ ج). در سطح ژنوم، نتایج eQTL با نتایج دو مجموعه داده تکهستهای بسیار سازگار بود و بالاترین سازگاری را برای انواع سلولهای منطبق داشت، با p1 از ۰.۷۳ تا ۰.۸۲ برای مجموعه داده Bryois، و از ۰.۸۴ تا ۰.۹۱ برای مجموعه داده Fujita (شکل تکمیلی ۲). تعداد ژنها با eQTLهای معنیدار آماری (یعنی eGenes) به طور گستردهای متفاوت بود، با ۱۰,۹۱۳ eGene در نورونهای تحریکی، اما تنها ۴۱۴ مورد در سلولهای اندوتلیال در سطح رده شناسایی شد. به طور مشابه، در سطح زیررده، ۸,۸۱۲ eGene در نورونهای تحریکی درونتلهانسفالی لایه ۲/۳ (EN_L2_3_IT) اما تنها ۱,۶۸۳ مورد در نورونهای تحریکی لایه ۶b (EN_L6B) شناسایی شد. تجزیه و تحلیل در سطح زیررده، وضوح سلولی را افزایش میدهد، در حالی که برخی از قدرت آماری را برای تشخیص اثرات مشترک در بسیاری از زیرردهها (یعنی نورونهای تحریکی) قربانی میکند. علاوه بر تفاوتها در چشمانداز تنظیمی ژنتیکی در انواع سلولها، قدرت آماری برای تشخیص اثرات تنظیمی ژنتیکی به شدت تحت تأثیر عوامل دیگر قرار دارد. در واقع، تعداد eGeneهای شناسایی شده با فراوانی نوع سلول (شکل ۱ د) و میانگین تعداد خوانش در هر نوع سلول (شکلهای تکمیلی ۳ و ۴) افزایش مییابد. علاوه بر این، ما سازگاری اندازههای اثر ژنتیکی را در سطح رده و زیررده در مقایسه با تجزیه و تحلیل در سطح تودهای که همه هستهها را جمعآوری میکند، ارزیابی کردیم. سازگاری به طور قابل توجهی با فراوانی نوع سلول افزایش یافت، با ردهها و زیرردههای نورونی که سازگاری بسیار بالاتری نسبت به غیرنورونها نشان دادند (شکل ۱ ه)، که با تولید RNA بالاتر و عمق توالییابی در نورونها سازگار است (شکلهای تکمیلی ۳ و ۴). سپس ما نقشهبرداری دقیق را برای پالایش مجموعه واریانتهای علّی کاندید، با تمرکز بر جایگاههای cis-eQTL انجام دادیم. در تمام جایگاههای معنیدار، اندازه مجموعه معتبر ۹۵% میانه از ده تا ۲۲ واریانت در سطح رده و ده تا ۳۰ واریانت در سطح زیررده متغیر بود (جدول تکمیلی ۱).
.
واریانتهای تنظیمی شناسایی شده در هر رده سلولی، زیستشناسی خاص آن رده را نشان میدهند. مناطق کروماتین باز (OCRs) خاص نوع سلول در اطراف واریانتهای اصلی eQTL از انواع سلولهای مربوطه غنی شده بودند (شکل ۱ و و شکل تکمیلی ۵). این یافته با برنامههای تنظیمی خاص نوع سلول، به ویژه برای گلیا، با غنیسازی کمتر برای نورونها همانطور که قبلاً مشاهده شد، سازگار است. با ادغام با یک آزمایش گزارشگر موازی گسترده در نورونهای تحریکی NGN2 مشتق از سلولهای بنیادی پرتوان القایی انسانی، مشاهده کردیم که در میان انواع سلولهای آزمایش شده، واریانتهای تنظیمی دقیق نقشهبرداری شده در نورونهای تحریکی قویترین ارتباط را با اندازه اثر آللی نشان دادند (شکل تکمیلی ۶).
بینشهای خاص نوع سلول و ویژگی در اختلالات عصبروانپزشکی و نورودژنراتیو
ادغام این کاتالوگ از تغییرات تنظیمی ژنتیکی با خطر ژنتیکی برای ویژگیهای پیچیده میتواند ژنها و انواع سلولهای زیربنای زیستشناسی بیماری را شناسایی کند. جفتهای انواع سلولها و ویژگیهایی که واریانتهای تنظیمی حاصل از نقشهبرداری دقیق آماری برای وراثتپذیری ویژگی غنی شده بودند، با استفاده از رگرسیون امتیاز عدم تعادل پیوستگی طبقهبندی شده (S-LDSC) پس از در نظر گرفتن حاشیهنویسیهای پایه شناسایی شدند (شکل ۲ الف و شکل تکمیلی ۷). واریانتهای تنظیمی نورونی برای وراثتپذیری ویژگیهای عصبروانپزشکی غنی شدهاند، با اسکیزوفرنی (SCZ) که گستردهترین غنیسازی را نشان میدهد، و پس از آن اختلال دوقطبی و اختلال افسردگی اساسی (MDD). با این حال، این ویژگیها در آستروسیتها و الیگودندروسیتها نیز غنی شدهاند، و SCZ و MDD نیز غنیسازی را در سلولهای پیشساز الیگودندروسیت (OPCs) نشان میدهند. ویژگیهای نورودژنراتیو بیماری آلزایمر (AD) و بیماری پارکینسون غنیسازی را در میکروگلیا نشان میدهند اما در زیرردههای نورونی نه. در تجزیه و تحلیل در سطح رده، جایی که قدرت بیشتری برای تشخیص اثرات مشترک در بسیاری از زیرردهها وجود دارد، بیماری پارکینسون، مولتیپل اسکلروزیس و اسکلروز جانبی آمیوتروفیک غنیسازی را در نورونها نشان میدهند (شکل تکمیلی ۷). سایر ویژگیهای پیچیده بررسی شده، غنیسازی برای واریانتهای تنظیمی مغز را نشان نمیدهند، به استثنای دیابت نوع ۲ و شاخص توده بدنی، که ویژگیهای متابولیکی با جزء رفتاری هستند. علاوه بر این، تجزیه و تحلیل میانجیگری وراثتپذیری نشان میدهد که واریانتهای تنظیمی در انواع سلولهای خاص نیز بخش قابل توجهی از وراثتپذیری برای ویژگیهای پیچیده را میانجیگری میکنند، با سیگنالهای قابل توجه برای SCZ در نورونها و AD در میکروگلیا (شکل تکمیلی ۸).
.
تجزیه و تحلیل همجایگزینی سیگنالهای ژنتیکی مشترک بین واریانتهای تنظیمی و خطر، ژنهای دخیل در اتیولوژی مولکولی بیماری را شناسایی کرد، از جمله ۴۶ ژن در AD، ۲۲ ژن در MDD و ۴۶ ژن در SCZ (شکل ۲ ب). قابل ذکر است که تا ۱۸ مورد از این ژنها منحصراً در تجزیه و تحلیلهای snRNA-seq شناسایی شدند و توسط مطالعات قبلی bulk RNA-seq شناسایی نشدند (شکل تکمیلی ۹). ارزیابی این سیگنالهای همجایگزینی در یک مجموعه داده مستقل، نرخهای تکرار مشابهی را برای سیگنالها در سطوح رده و زیررده نشان داد (شکل تکمیلی ۱۰). اگرچه برخی از ژنها در تجزیه و تحلیلهای سطح رده و زیررده مشترک هستند، بسیاری از آنها فقط در یک سطح شناسایی میشوند که اهمیت تجزیه و تحلیلهای چندرزولوشنی را برجسته میکند. در سطح رده، بسیاری از ژنهای همجایگزینی شده برای SCZ فقط در نورونهای تحریکی و بازدارنده شناسایی میشوند، مانند FUT9، SNORD3A، ACE و FURIN، در حالی که برخی دیگر، مانند ACTR1B و ZNF832، با انواع سلولهای دیگر نیز مشترک هستند (شکل ۲ ج). DRD2، PTPRU، MLF2 و FAM171A1 فقط در نورونهای تحریکی شناسایی میشوند، در حالی که RASA3، SP4، MAP3K12، ERBB4 و KCNG2 فقط در نورونهای بازدارنده شناسایی میشوند.
.
تجزیه و تحلیل همجایگزینی برای AD، انواع سلولهای کلیدی را که سیگنالهای تنظیمی و خطر بیماری را به اشتراک میگذارند، شناسایی میکند. نقش میکروگلیا در مکانیسمهای ژنتیکی زیستشناسی AD به خوبی تثبیت شده است، با ۱۶ ژن که سیگنال همجایگزینی را در سلولهای ایمنی نشان میدهند، که عمدتاً توسط میکروگلیا هدایت میشود (شکل ۲ د). با این حال، ۹ ژن در الیگودندروسیتها، ۱۲ ژن در آستروسیتها و شش ژن در نورونها در سطح رده شناسایی میشوند، با همپوشانی بسیار محدود بین انواع سلولها. این مکانیسمهای مولکولی را علاوه بر مواردی که در اتیولوژی AD شامل میکروگلیا هستند، برجسته میکند. ژنهای میکروگلیایی برای مسیرهای دخیل در تشکیل آمیلوئید-بتا و پردازش APP غنی شده بودند که با نقش تثبیت شده میکروگلیا در زیستشناسی پلاک سازگار است. نورونهای تحریکی و بازدارنده برای پاسخ هورمون تیروئید و فرآیندهای کاتابولیک پپتید غنی شده بودند که مکانیسمهای تنظیمی ذاتی نورون را که بر متابولیسم آمیلوئید تأثیر میگذارند، نشان میدهد. الیگودندروسیتها برای فعالسازی مکمل و مسیرهای پاسخ ایمنی هومورال غنی شده بودند که نقش ایمنی-تنظیمی بالقوه برای الیگودندروسیتها در پاتوژنز AD را برجسته میکند (شکل تکمیلی ۱۱).
.
تجزیه و تحلیل در سطح زیررده با وضوح بالاتر، ژنهای اضافی را شناسایی میکند که در سطح رده یافت نمیشوند (شکل ۲ ه و شکل تکمیلی ۱۲). این ژنها تمایل دارند سیگنالهای همجایگزینی را در زیرمجموعههایی از نورونها نشان دهند، با توجه به اینکه با ادغام زیرردههای متنوع نورونی به تنها ردههای نورونهای تحریکی و بازدارنده، نادیده گرفته شدند. به عنوان مثال، CNTN4 که پروتئین کنتاکتین ۴ دخیل در چسبندگی سلولی را کد میکند، تنها با خطر SCZ در نورونهای تحریکی کورتیکوتالامیک لایه ۶ (EN_L6_CT) همجایگزینی داشت (شکل ۲ و). به طور مشابه، SORL1 که گیرنده مرتبط با سورتیلین ۱ را کد میکند، با خطر AD در میکروگلیا همجایگزینی داشت اما نه در ماکروفاژهای پریواسکولار در سطح زیررده یا نوع سلول «ایمنی» با وضوح پایینتر در سطح رده (شکل تکمیلی ۱۳). ما همچنین هشت جایگاه در سطح رده و ۱۱ جایگاه در سطح زیررده را یادآور میشویم که شامل چندین ژن با سیگنالهای همجایگزینی در فاصله ۱ مگابایت هستند (جدول تکمیلی ۲).
اختصاصی بودن نوع سلول در اثرات تنظیمی ژنتیکی، مکانیسمهای متمایز در خطر بیماری نورودژنراتیو را آشکار میکند
انواع مختلف سلولها نقشهای کلیدی در سلامت و بیماری دارند و توصیف تفاوتها در اثرات تنظیمی ژنتیکی با وضوح بالاتر میتواند بینشی را در مورد عملکردهای متمایز این انواع سلولها ارائه دهد. اگرچه اختصاصی بودن نوع سلول در زیستشناسی تنظیمی و بیماری به طور گستردهای مورد قدردانی قرار گرفته است، اما شناسایی یک اثر تنظیمی خاص نوع سلول از یک واریانت ژنتیکی به روشی آماری دقیق چالشبرانگیز است. صرفاً تشخیص یک ارتباط معنیدار بین یک واریانت ژنتیکی و بیان یک ژن در یک نوع سلول اما نه در دیگری، به این معنی نیست که اثر بیولوژیکی خاص نوع سلول اول است. این معضل زمانی رایج است که قدرت آماری محدود باشد، یا زمانی که تفاوت قابل توجهی در قدرت بین انواع سلولها وجود داشته باشد. در واقع، آمارهای فراوانیگرا (frequentist statistics) که به طور گستردهای استفاده میشوند، برای پرداختن به این سؤال مهم ناکافی هستند.
.
ما از یک فراتحلیل بیزی چندمتغیره (multivariate Bayesian meta-analysis) برای تولید برآوردهای پسین از اندازه اثر eQTL و احتمال پسین که هر اثر ژنتیکی غیرصفر است، استفاده میکنیم. این رویکرد برآوردهای اندازه اثر را در میان ژنها و انواع سلولها کوچک میکند تا نسبت به تفاوتها در قدرت آماری مقاومتر باشد. بررسی ژنهایی با eQTLهای شناسایی شده در یک نوع سلول با این رویکرد بیزی و تقاطع با نتایج همجایگزینی، ژنتیک تنظیمی خاص و نقش آنها را در زیستشناسی بیماری برجسته میکند (شکل ۳ الف). به عنوان مثال، بررسی همجایگزینی با AD نشان میدهد که واریانتهای تنظیمی ژنتیکی برای BIN1 و EPHA1-AS1 فقط در میکروگلیا شناسایی میشوند، و برای SERPINB1 و GALNT6، فقط در الیگودندروسیتها. ژن کلیدی AD، APP، که پروتئین پیشساز آمیلوئید را کد میکند، یک سیگنال تنظیمی ژنتیکی خاص الیگودندروسیتها و همچنین یک سیگنال دیگر در آستروسیتها دارد که با انواع سلولهای دیگر مشترک است. ژنهای دیگر سیگنالهای eQTL جداگانه را در انواع سلولهای متمایز شناسایی کردهاند. INPP5D یک سیگنال eQTL را فقط در میکروگلیا و یک سیگنال جداگانه را فقط در آستروسیتها شناسایی کرده است، در حالی که EGFR، PSD3، NALCN، TLE4 و WNT5B هر کدام سیگنالهای eQTL جداگانه را در انواع سلولهای متمایز شناسایی کردهاند (شکل تکمیلی ۱۴).
.
با استفاده از یک رویکرد فرضیه ترکیبی جدید، میتوانیم به طور مستقیم احتمال پسین را که یک اثر تنظیمی ژنتیکی خاص یک نوع سلول معین است، تخمین بزنیم. تجزیه و تحلیل در سطح زیررده، ۸۵۷ ژن منحصر به فرد را با اثرات خاص نوع سلول با احتمال پسین > ۰.۵ شناسایی کرد، با ۹۸۱ ژن در سطح رده (شکل ۳ ب و شکل تکمیلی ۱۵). در سطح زیررده، الیگودندروسیتها بیشترین اثرات تنظیمی ژنتیکی خاص نوع سلول را با ۳۱۳ ژن دارند، و پس از آن آستروسیتها با ۱۴۵ و میکروگلیا با ۱۴۳ ژن قرار دارند. استفاده از آستانههای احتمال پسین سختگیرانهتر در ۰.۸، اثرات خاص نوع سلول را حفظ میکند: ۶۳۰ در سطح رده و ۶۴۴ در سطح زیررده (شکل تکمیلی ۱۵). اگرچه انواع سلولها با بیشترین یافتههای خاص نوع سلول از نظر بیولوژیکی از سایر زیرردهها متمایز هستند، نورونها شامل چندین زیررده مشابه هستند و اختصاصی بودن نوع سلول کمتری را نشان میدهند. ما آزمایش ترکیبی اضافی را برای شناسایی اثرات ژنتیکی موجود در حداقل یک نوع سلول تشکیلدهنده انجام دادیم.
.
ژن EGFR که گیرنده فاکتور رشد اپیدرمی را کد میکند، دارای الگوی پیچیدهای از تنظیم ژنتیکی خاص نوع سلول و همجایگزینی با خطر بیماری است. این ژن حداقل دو برنامه تنظیمی جداگانه در آستروسیتها و الیگودندروسیتها دارد. واریانت اصلی برای سیگنال آستروسیت rs74504435 است که دارای احتمال پسین ترکیبی ۰.۹۴۶ است که فقط با بیان EGFR در آستروسیتها مرتبط است (شکل ۳ ج). این سیگنال تنظیمی ژنتیکی در آستروسیتها با خطر AD همجایگزینی دارد، در حالی که سیگنال تنظیمی در الیگودندروسیتها با خطر AD مرتبط نیست، که نقش خاص نوع سلول در زیستشناسی بیماری را برجسته میکند (شکل ۳ د).
تنظیم ژنتیکی پویا در طول تکامل عصبی، اثرات eQTL متغیر و ارتباط با خطر بیماری را شناسایی میکند
تکامل عصبی یک فرآیند بیولوژیکی کلیدی در اتیولوژی ویژگیهای مرتبط با مغز است و بیان ژن در برخی از انواع سلولها در طول زمان تکاملی به طور قابل توجهی تغییر میکند. ما استدلال کردیم که اثرات تنظیمی ژنتیکی بر بیان ژن نیز در طول زمان تکاملی تغییر میکنند. با زیرمجموعهسازی مجموعه داده کامل PsychAD، یک مطالعه قبلی یک گروه سنی نوروتیپیک (neurotypical) از ۲۸۴ اهداکننده پس از مرگ با سن ۰ تا ۹۷ سال را استخراج کرد که شامل ۱.۳ میلیون هسته بود و یک مسیر شبهزمان (pseudotime trajectory) برای هر نوع سلول با استفاده از یک روش نظارت شده که سن اهداکننده را در بر میگرفت، ساخت. مسیر برای هر نوع سلول در اوایل تکامل لنگر انداخته و به سمت بزرگسالی گسترش مییابد، با هر هسته که یک مقدار شبهزمان پیوسته (continuous pseudotime value) به آن اختصاص داده شده است (شکل ۴ الف). اثرات eQTL پویا برای هر نوع سلول با آزمایش اینکه آیا اندازه اثر ژنتیکی یک واریانت معین بر بیان یک ژن معین در طول این مسیر تغییر میکند، شناسایی شد. تجزیه و تحلیل با استفاده از یک مدل ترکیبی دوجملهای منفی (negative binomial mixed model) برای در نظر گرفتن هستههای متعدد از هر اهداکننده و در نظر گرفتن پراکندگی بیش از حد شمارشهای مشاهده شده انجام شد. به عنوان مثال، در نورونهای تحریکی، اثر ژنتیکی rs1878289 بر بیان NGEF، که یک فاکتور تبادل گوانین نوکلئوتید نورونی را کد میکند، در طول بلوغ سلولی به طور قابل توجهی افزایش مییابد (شکل ۴ ب). در مجموع، ۲,۰۷۳ ژن منحصر به فرد با eQTLهای پویا با نرخ کشف کاذب (FDR) ۵% شناسایی شدند، با تعداد متغیر از ۱,۳۶۴ در نورونهای تحریکی تا تنها ۹ مورد در OPCs، با بالاترین همپوشانی بین نورونهای تحریکی و بازدارنده (شکل ۴ ج). این یافته با دینامیک تکاملی گسترده و تنوع سلولی نورونهای تحریکی در مقایسه با همگنی نسبی OPCs سازگار است. ژنها با eQTLهای پویا برای فرآیندهای تکاملی مانند تولید نورونها و سازماندهی اتصال سلولی در انواع سلولهای متعدد غنی شدهاند (شکل ۴ د). آستروسیتها غنیسازی را برای فرآیندهای سیستم عصبی مرتبط با فشار خون شریانی نشان میدهند که با نقش کلیدی آنها در تولید آنژیوتانسین سازگار است. نورونهای تحریکی غنیسازی را برای تکامل و تمایز نورونی نشان میدهند، در حالی که نورونهای بازدارنده غنیسازی را برای مهاجرت نورون و میکروگلیا غنیسازی را برای آکسونوژنز نشان میدهند. الیگودندروسیتها برای ژنهای دخیل در مونتاژ بلب (bleb assembly) غنی شدهاند، یک فرآیند مورفولوژیکی و مهاجرتی مهم.
.
ژنهایی با سیگنالهای تنظیمی پویا که در نورونهای تحریکی، نورونهای بازدارنده و الیگودندروسیتها شناسایی شدهاند، برای ژنهایی با سیگنالهای همجایگزینی بیماری که در بالا شناسایی شدند، غنی شدهاند که اهمیت دینامیک تنظیمی در زیستشناسی بیماری را تأکید میکند (شکل ۴ ه). ژنها اغلب یک سیگنال تنظیمی پویا را در یک نوع سلول و یک سیگنال همجایگزینی بیماری را در یک نوع سلول متفاوت شناسایی کردهاند. ما این را برای AD (شکل ۴ و)، SCZ، MDD و اختلال طیف اوتیسم (شکلهای تکمیلی ۱۶ و ۱۷) مشاهده میکنیم. این اثر را میتوان به تفاوتها بین معماری تنظیمی که تغییرات پویا در بیان ژن را در طول پیری هدایت میکند و ژنتیک مؤثر بر بیان ژن در حالت پایدار، تفاوتها در مسیرهای پیری در انواع سلولها و تفاوتها در قدرت آماری در انواع سلولها نسبت داد. در همین حال، شش ژن دارای یک سیگنال تنظیمی پویا و سیگنال همجایگزینی بیماری هستند که در همان رده سلولی شناسایی شدهاند (شکل تکمیلی ۱۸). CLU و SNX31 دارای یک سیگنال تنظیمی پویا و سیگنال همجایگزینی با AD در آستروسیتها، ACTRB و FAM171A1 با SCZ در نورونهای تحریکی، BIN1 با AD در سلولهای ایمنی و NEGR1 با MDD در الیگودندروسیتها هستند.
نقشهبرداری Trans-eQTL مراکز تنظیمی ژنتیکی خاص نوع سلول مغز و ارتباط با خطر بیماری را شناسایی میکند
واریانتهای ژنتیکی واقع در خارج از پنجره تنظیمی cis-محلی یک ژن میتوانند از طریق مکانیسمهای تنظیمی trans-تأثیر قابل توجهی بر بیان ژن اعمال کنند. تجزیه و تحلیل سیگنالهای تنظیمی trans-در هر رده سلولی، ۱,۶۵۵ ژن منحصر به فرد را با سیگنالهای trans-eQTL > ۵ مگابایت از بدنه ژن با FDR ۵% در سراسر مطالعه شناسایی میکند. تعداد trans-eGeneها بر اساس نوع سلول متفاوت بود، از ۴۰۷ در الیگودندروسیتها تا ۲۱۰ در سلولهای ایمنی، با همپوشانی محدود در انواع سلولها (شکل ۵ الف). تجزیه و تحلیل این کشفهای trans-eQTL در گروه مستقل Fujita، نرخهای تکرار تخمینی را از ۶۶% تا ۹۵%، بسته به نوع سلول، نشان داد (شکل تکمیلی ۱۹). تجزیه و تحلیل واریانتهای ژنتیکی مرتبط با چندین trans-eGene، چهار مرکز تنظیمی trans-را شناسایی کرد که در سه تنظیمکننده رونویسی (SUPT3H، RUNX2 و ZNF160) متمرکز شده بودند، هر کدام حداقل سه ژن هدف را تحت تأثیر قرار میدادند، با بزرگترین مرکز که نه هدف پاییندستی را در الیگودندروسیتها تنظیم میکرد (شکل ۵ ب و شکل تکمیلی ۲۰). با تقاطع trans-eGeneها با ژنهایی که سیگنالهای تنظیمی cis-را نشان میدهند که با خطر بیماری همجایگزینی دارند، ما ۱۲ ژن را با احتمال همجایگزینی > ۰.۸ و ۳۲ ژن را با احتمال همجایگزینی > ۰.۵ شناسایی میکنیم (شکل تکمیلی ۲۱ و جدول تکمیلی ۳).
.
برای بررسی بیشتر مکانیسمهای تنظیمی زیربنای سیگنالهای trans-eQTL، ما تجزیه و تحلیل میانجیگری ژنتیکی را برای آزمایش آماری اینکه آیا اثر trans-eQTL واقعاً توسط تنظیم یک ژن cis-میانجیگری میشود، انجام دادیم. اگرچه تجزیه و تحلیل برای تشخیص تعداد زیادی از میانجیگرهای cis-در آستانه معنیداری سراسر مطالعه با FDR ۵% کمتوان بود، با استفاده از روش p1 استوری، تخمین میزنیم که ۴۳% از سیگنالهای trans-توسط ژنهای cis-میانجیگری میشوند، با تشخیص عمدتاً محدود شده توسط قدرت آماری. با این حال، ما ۴۲ trans-eQTL را شناسایی کردیم که توسط ژنهای cis-در الیگودندروسیتها میانجیگری میشوند، با تعداد کمتری که در سایر ردههای سلولی شناسایی شدند (شکل ۵ ج).
.
در آستروسیتها، تجزیه و تحلیل میانجیگری از این فرضیه حمایت میکند که سیگنال trans-eQTL بین rs2120461 روی کروموزوم ۱ و بیان AUTS2 روی کروموزوم ۷ توسط یک اثر تنظیمی cis-بر بیان RERE میانجیگری میشود (FDR = ۱.۵ × ۱۰-۳) (شکل ۵ د). این trans-eQTL و میانجیگری در مجموعه داده مستقل Fujita تکرار شدهاند (شکل تکمیلی ۲۲). هر دو RERE و AUTS2 در اختلالات تکاملی عصبی و عصبروانپزشکی دخیل هستند. RERE یک تنظیمکننده رونویسی است که در سیگنالدهی اسید رتینوئیک در اوایل تکامل نقش دارد، و AUTS2 در تمایز نورونی نقش دارد. علاوه بر این، تجزیه و تحلیل همجایگزینی نشان داد که تنظیم cis-ژن RERE و تنظیم trans-ژن AUTS2، هرچند به طور ضعیف، با خطر ژنتیکی برای SCZ همجایگزینی دارند (شکل ۵ ه). این مشاهده یک مدل مکانیکی را پیشنهاد میکند که در آن تنظیم ژنتیکی RERE و اثر پاییندستی آن بر AUTS2 در آستروسیتها به حساسیت SCZ کمک میکند (شکل ۵ و).
بحث
مغز از مجموعهای متنوع از انواع سلولها با زیستشناسی متمایز، الگوهای بیان ژن، معماری تنظیمی ژنتیکی و نقشها در تکامل و بیماری تشکیل شده است. واریانتهای ژنتیکی خطرناک برای ویژگیهای پیچیده عمدتاً با تغییر بیان ژن عمل میکنند؛ با این حال، درک ما از تغییرات تنظیمی خاص نوع سلول و نقش آن در بیماری توسط اندازه نمونه و وضوح نوع سلول محدود شده است. در اینجا، ما یک اطلس چندرزولوشنی از تنظیم ژنتیکی در مغز انسان را ارائه میدهیم که شامل هشت رده سلولی و ۲۷ زیررده است که از ۵.۶ میلیون هسته منفرد به دست آمده از ۱,۳۸۴ اهداکننده با تبارهای متنوع تولید شده است. ما cis-eQTLها را برای ۱۴,۲۵۸ ژن شناسایی میکنیم و تغییرات گستردهای را در تعداد cis-QTLهای شناسایی شده برای هر رده و زیررده سلولی به دلیل تفاوت در فراوانی نوع سلول مشاهده میکنیم. این یافته اهمیت افزایش اندازه نمونه برای مطالعه معماری تنظیمی انواع سلولهای نادرتر را برجسته میکند. سیگنالهای تنظیمی در انواع سلولها متمایز هستند و برای سلولهای غیرنورونی، دسترسی کروماتین را در هر نوع سلول منعکس میکنند.
.
ادغام با GWAS برای ویژگیهای مرتبط با مغز، انواع سلولهایی را که خطر ژنتیکی را برای هر ویژگی میانجیگری میکنند، شناسایی میکند. تجزیه و تحلیل همجایگزینی، ژنها و انواع سلولهای خاصی را که خطر ژنتیکی را میانجیگری میکنند و بینشی را در مورد زیستشناسی بیماری اضافه میکنند، شناسایی میکند. نقش نورونها در SCZ به خوبی تثبیت شده است، اما نقش زیرتایپهای نورونی به خوبی درک نشده است. به عنوان گامی به سوی درک با وضوح بالاتر، ما چندین ژن را شناسایی کردیم که با خطر SCZ در زیرتایپهای نورونی خاص همجایگزینی دارند. اگرچه نقش تنظیم ژنتیکی بیان CNTN4 در SCZ ابتدا از پروفایلسازی بیان ژن تودهای شناسایی شد، ما یک سیگنال خطر تنظیمی و SCZ مشترک را فقط در نورونهای تحریکی کورتیکوتالامیک لایه ۶ پیدا میکنیم.
.
کار اخیر در AD نقش منحصر به فرد میکروگلیا، سلولهای میلوئیدی ساکن مغز، را در خطر ژنتیکی و اتیولوژی مولکولی آشکار کرده است. علاوه بر شناسایی سیگنالهای تنظیمی ژنتیکی مشترک با خطر AD در میکروگلیا، ما ژنهایی را نیز شناسایی میکنیم که در میکروگلیا شناسایی نمیشوند. از جمله اینها، ژنهای به خوبی مطالعه شدهای مانند APP، SNX31، SNX32، EGFR و CLU در آستروسیتها؛ CR1 و CR2 در الیگودندروسیتها؛ و CTSB، CTSH و ACE در نورونها هستند.
.
شناسایی اثرات تنظیمی خاص نوع سلول، که در آن یک اثر ژنتیکی فقط در یک نوع سلول مشخص غیرصفر است، با روشهای فراوانیگرای موجود چالشبرانگیز است. با تکیه بر فراتحلیل بیزی چندمتغیره، ما ژنها را بر اساس سیگنالهای تنظیمی خاص در مقابل مشترک اولویتبندی میکنیم و معماری تنظیمی پیچیدهای را که در انواع سلولهای خاص فعال است، بررسی میکنیم. ما مثال EGFR را برجسته میکنیم که حداقل دو برنامه تنظیمی متمایز دارد؛ یکی در آستروسیتها و دیگری در الیگودندروسیتها فعال است. قابل ذکر است که فقط سیگنال تنظیمی در آستروسیتها با خطر ژنتیکی AD همجایگزینی دارد، که اهمیت برنامههای تنظیمی خاص نوع سلول را در زیستشناسی بیماری برجسته میکند.
.
فرآیندهای تکاملی اولیه نقش کلیدی در بیماریهای تکاملی عصبی و عصبروانپزشکی دارند. با این حال، مطالعه معماری تنظیمی ژنتیکی با وضوح نوع سلول در این مرحله کلیدی به ویژه چالشبرانگیز است. در اینجا، ما از طیف سنی گسترده اهداکنندگان در این مجموعه داده استفاده میکنیم و با یک گروه سنی نوروتیپیک از PsychAD ادغام میکنیم تا یک مسیر شبهزمان را در هر رده سلولی بسازیم. ما eQTLهای پویا را با آزمایش اثرات ژنتیکی که در طول زمان تکاملی تغییر میکنند، شناسایی میکنیم. اثرات ژنتیکی پویا در نورونهای تحریکی و بازدارنده بیشترین شیوع را دارند، و eGeneهای پویا در این ردهها برای همجایگزینی با ویژگیهای مرتبط با مغز غنی شدهاند.
.
مقیاس منحصر به فرد این مجموعه داده، کشف trans-eQTLها را برای فراوانترین ردههای سلولی امکانپذیر ساخت. ما همپوشانی محدودی را بین ردههای سلولی پیدا میکنیم و trans-eGeneهایی را شناسایی میکنیم که همچنین دارای یک سیگنال تنظیمی cis-هستند که با خطر بیماری همجایگزینی دارد. در آستروسیتها، ما یک cis-eQTL را برای RERE به عنوان یک trans-eQTL برای AUTS2 شناسایی میکنیم، و هر دو سیگنال تنظیمی با خطر ژنتیکی برای SCZ همجایگزینی داشتند، که نقش معماری پیچیده trans-تنظیمی را در زیستشناسی بیماری تأکید میکند.
.
اگرچه ترانسکریپتومیکس تکسلولی و تکهستهای نقشهبرداری با وضوح بالا از بیان خاص نوع سلول را امکانپذیر میسازد، اما قدرت تشخیص eQTLها به شدت تحت تأثیر فراوانی نوع سلول و تا حد کمتری، عمق توالییابی قرار دارد. به دلیل تنوع گسترده در نسبتهای نوع سلول، ردههای سلولی اصلی، مانند نورونهای بازدارنده، نورونهای تحریکی، الیگودندروسیتها و آستروسیتها، تعداد بیشتری از eQTLهای قابل تشخیص را نسبت به جمعیتهای نادرتر، از جمله سلولهای ایمنی، اندوتلیال و جداری نشان میدهند. طبقهبندی بیشتر به ۲۷ زیررده سلولی، وضوح سلولی را افزایش میدهد اما اغلب قدرت آماری را نسبت به تجزیه و تحلیلهای سطح رده به دلیل کاهش اندازههای نمونه در هر زیررده کاهش میدهد. این تعادل بین جزئیات سلولی و قدرت آماری یک ملاحظه حیاتی در طراحی و تفسیر مطالعات eQTL تکسلولی است.
.
یافتههای ما بینشهای کلیدی را در مورد تنظیم ژنتیکی خاص نوع سلول زیربنای بیماریهای عصبروانپزشکی و نورودژنراتیو ارائه میدهد. این مطالعه اهمیت گسترش اندازههای نمونه و افزایش وضوح تکسلولی را برای شناسایی انواع سلولهای نادرتر تأکید میکند و راه را برای درک عمیقتر مکانیسمهای بیماری هموار میسازد. همانطور که به جلو میرویم، ادغام دادههای چنداومیک و اطمینان از نمایش تبارهای متنوع برای پیشرفت پزشکی دقیق و توسعه استراتژیهای درمانی هدفمند برای اختلالات مغزی حیاتی خواهد بود.
روشها
کلیه رویهها و پروتکلهای تحقیقاتی توسط هیئتهای بازبینی سازمانی (IRBs) مرکز پزشکی دانشگاه راش و مرکز پزشکی کوه سینا و کوه سینا/جیمز جی. پیترز VA تأیید شدند. نمونههای مغزی کالبدشکافی شده از برنامههای اهدای مغز در مرکز پزشکی دانشگاه راش/مرکز بیماری آلزایمر راش و بانک مغز کوه سینا، شامل نمونههای جمعآوری شده از مخزن مغز و بافت مؤسسات ملی بهداشت (NIH) مرکز پزشکی جیمز جی. پیترز VA، منشأ گرفتند. کلیه تحقیقات با اصول اعلامیه هلسینکی مطابقت داشتند. شرکتکنندگان غرامت دریافت نکردند. تعداد نمونهها با توجه به در دسترس بودن کالبدشکافیهای مغزی تازه تعیین شد. هیچ روش آماری برای تعیین اندازه نمونه از پیش استفاده نشد.
انتخاب و پیشپردازش نمونه
بافت مغز از DLPFC از ۱,۴۹۴ اهداکننده توسط کنسرسیوم PsychAD به دست آمد. این مجموعه داده شامل اهداکنندگان از سه منبع بود. مخزن بافت مرکز بیماری آلزایمر راش از مطالعه دستورات مذهبی یا پروژه حافظه و پیری راش ۱۵۲ نمونه ارائه کرد؛ هسته جمعآوری مغز انسان ۳۰۰ نمونه؛ و بانک مغز کوه سینا (دانشکده پزشکی کوه سینا) ۱,۰۴۲ نمونه ارائه کرد. این گروه شامل تعداد مشابهی از مردان و زنان است و کل محدوده سنی پس از تولد از ۰ تا ۱۰۸ سال را در بر میگیرد. برای جزئیات بیشتر در مورد اهداکنندگان و پردازش دادهها به کارهای قبلی منتشر شده مراجعه کنید.
.
خوانشهای جفتشده از کتابخانههای snRNA-seq با استفاده از STAR solo به ژنوم مرجع hg38 تراز شدند و مجموعههای نمونه از طریق تطبیق ژنوتیپ با Vireo (v0.5.8) دمولتیپلکس شدند. پس از تولید ماتریسهای شمارش برای هر کتابخانه، پردازش پاییندستی با استفاده از Pegasus (v.1.7.0) و scanpy (v.1.9.1) انجام شد.
.
ما یک فرآیند کنترل کیفیت سختگیرانه را برای حذف RNA محیطی و حفظ هستههای با کیفیت بالا برای تجزیه و تحلیل بیشتر پیادهسازی کردیم. به عنوان بخشی از خط لوله کنترل کیفیت دقیق ما، ابتدا آلودگی احتمالی را با استفاده از CellBender (v0.4.0)، یک مدل تولیدی عمیق که به طور خاص برای حذف شمارشهای ناشی از مولکولهای RNA محیطی و تعویض تصادفی بارکد طراحی شده است، آزمایش کردیم. با این حال، در ارزیابی اولیه خود، آلودگی قابل توجه RNA محیطی را در مجموعههای داده خود مشاهده نکردیم. علاوه بر این، برای اطمینان از بالاترین دقت شیء پردازش شده نهایی و تأیید قوی اینکه نتایج اختصاصی بودن نوع سلول ما ناشی از نویز پسزمینه نیست، ما تجزیه و تحلیل اضافی را با استفاده از SoupX (1.6.2) انجام دادیم. این اعتبار سنجی ثانویه تأیید کرد که دادههای ما عاری از اثرات قابل توجه RNA محیطی هستند.
.
DNA ژنومی از بافت مغز منجمد با استفاده از کیت QIAamp DNA Mini (Qiagen)، طبق دستورالعمل سازنده، استخراج شد. نمونهها با استفاده از آرایه Infinium Psych Chip (Illumina) در هسته توالییابی کوه سینا ژنوتیپ شدند. پردازش پیش از استنباط شامل اجرای اسکریپت کنترل کیفیت HRC-1000G-check-bim.pl از گروه آزمایشگاه مککارتی، با استفاده از برنامه Trans-Omics for Precision Medicine (TOPMed) بود. ژنوتیپها در سرور استنباط TOPMed (https://imputation.biodatacatalyst.nhlbi.nih.gov) فازبندی و استنباط شدند. نمونهها در صورت عدم تطابق بین جنسیت خودگزارش شده و ژنتیکی استنباط شده، آنوپلوئیدی کروموزوم جنسی مشکوک، خویشاوندی بالا (ضریب خویشاوندی KING > ۰.۱۷۷) یا هتروزیگوسیتی پرت (±۳ انحراف معیار از میانگین) حذف شدند. علاوه بر این، نمونههایی با از دست رفتن در سطح نمونه > ۰.۰۵، که در زیرمجموعهای از واریانتهای با کیفیت بالا (از دست رفتن در سطح واریانت = ۰.۰۲) محاسبه شده بود، حذف شدند. در مجموع، ۱,۳۸۴ اهداکننده با دادههای ژنوتیپ و دادههای snRNA-seq که از کنترل کیفیت عبور کردند، در این مطالعه تجزیه و تحلیل شدند.
حاشیهنویسی سلولی
حاشیهنویسیهای سلولی مجموعه داده PsychAD در سطح رده و زیررده در یک مقاله همراه ارائه شده است. طبقهبندی سلولی با استفاده از استراتژی تقسیم و غلبه تعریف شد. از مجموعه داده کامل PsychAD که شامل بیش از شش میلیون هسته بود، هشت رده سلولی اصلی با استفاده از مراحل زیر تعریف شدند: ۶,۰۰۰ ژن با تغییرپذیری بالا (HVGs) از روندهای میانگین و پراکندگی با استفاده از پارامترهای پیشفرض (min_mean = ۰.۰۱۲۵، max_mean = ۳، min_disp = ۰.۵) و منبع مغز به عنوان یک متغیر دستهای پس از حذف دستی کروموزومهای جنسی و میتوکندریایی انتخاب شدند. ما از نمودار نزدیکترین همسایه k (kNN) که بر اساس فضای جاسازی تحلیل مؤلفه اصلی اصلاح شده با هارمونی محاسبه شده بود، برای خوشهبندی هستههای یک نوع سلول با استفاده از الگوریتم خوشهبندی لیدن استفاده کردیم. ما از نگاشت یکنواخت و کاهش ابعاد (UMAP) برای تجسم خوشههای حاصل استفاده کردیم. از خوشههای سطح رده، دادهها را بر اساس هر رده زیرمجموعهبندی کردیم. محاسبه مجدد HVGs در میان سلولهای یک رده به ما امکان داد تا دوباره بر روی یک فضای ویژگی تمرکز کنیم که برای همان رده سلولها مرتبطتر است. سپس یک نمودار kNN بر اساس تحلیل مؤلفه اصلی اصلاح شده با هارمونی HVGs انتخاب شده محاسبه شد. خوشهبندی لیدن برای حاشیهنویسی ۲۷ حاشیهنویسی در سطح زیررده استفاده شد. ما همان خوشهبندی HVG–kNN–لیدن را برای همه ۲۷ زیررده تکرار کردیم که منجر به ۶۷ زیرتایپ از سلولهای مغز انسان شد. پس از به دست آوردن حاشیهنویسیها در سه سطح سلسله مراتبی، خوشههای حاصل به پروفایلهای شبهتودهای (pseudobulk) جمعآوری شدند و ضرایب همبستگی پیرسون بین خوشهها با استفاده از حاشیهنویسیهای موجود DLPFC و M1 انسانی محاسبه شدند. ما حاشیهنویسیها را بر اساس همبستگی بالا و اختصاصی بودن نوع سلول تطبیق دادیم.
نرمالسازی بیان ژن
شمارشهای خوانش شبهتودهای با جمعآوری خوانشها از یک فرد با استفاده از گردش کار dreamlet محاسبه شد. همانطور که در مقاله همراه انجام شد، ما تجزیه و تحلیل تقسیم واریانس را برای شناسایی متغیرهای مرتبط با بیان ژن انجام دادیم. این کار نسبت بیان میتوکندریایی را به عنوان یک متغیر مهم شناسایی کرد؛ این متغیر برای کاهش تغییرپذیری فنی مرتبط با اثرات دستهای، کیفیت سلول و مصنوعات بالقوه مرتبط با استرس، رگرسیون شد. علاوه بر این، اثرات مجموعه نمونه و تأثیر وضعیت بیماری نیز با رگرسیون کنترل شدند. در نهایت، باقیماندهها بر انحراف معیار پیشبینی شده تقسیم شدند تا باقیماندههای پیرسون را تولید کنند، که تأثیر عمقهای توالییابی متغیر در کتابخانههای scRNA-seq را حذف میکند.
.
ما از بسته PEER برای شناسایی کوواریانسهای پنهان مشاهده نشده استفاده کردیم. برای یافتن تعداد بهینه عوامل PEER برای حذف، ما تشخیص eQTL را بر روی ماتریس بیان ورودی، نرمال شده توسط کوواریانسهای بیولوژیکی و فنی از پیش انتخاب شده، با تغییر تعداد عوامل PEER از ده به ۹۸ در افزایشهای چهار تایی انجام دادیم. تنظیم با بیشترین eQTLهای معنیدار در سراسر ژنوم شناسایی شده به عنوان نتیجه نهایی برای تجزیه و تحلیل پاییندستی استفاده شد (شکل تکمیلی ۲۳).
تجزیه و تحلیل واریانتهای تنظیمی ژنتیکی در سطح شبهتودهای
تجزیه و تحلیل در سطح شبهتودهای انجام شد. برای هر نوع سلول، اهداکنندگان با حداقل پنج هسته برای اطمینان از برآوردهای پایدار بیان در سطح اهداکننده و کاهش نویز ناشی از نمونهبرداری پراکنده حفظ شدند. ژنها در هر نوع سلول فیلتر شدند تا فقط آنهایی که به طور قوی بیان شده بودند، حفظ شوند. این روش فیلتر کردن با استفاده از edgeR::filterByExpr() پیادهسازی شد و نیاز داشت که حداقل ۴۰% از اهداکنندگان حداقل پنج خوانش در هر ژن داشته باشند. پس از کنترل کیفیت و فیلتر کردن، تعداد اهداکنندگان حفظ شده برای هر گروه متفاوت بود (جدول تکمیلی ۴).
.
باقیماندههای رگرسیون استفاده شده در تجزیه و تحلیل eQTL به شرح زیر تولید شدند. بیان برای هر نوع سلول و هر فرد به عنوان لگاریتم ۲ شمارش در هر میلیون با یک شبهشمارش ۰.۲۵ پس از جمعآوری تمام هستههای مربوطه محاسبه شد. یک مدل رگرسیون با وزن دقت برای هر ژن بیان شده در هر نوع سلول با بسته dreamlet (v1.4.1) با استفاده از کوواریانسها برای سن، جنسیت، فاصله پس از مرگ، نرخ میتوکندریایی، نرخ ریبوزومی و وضعیت بیماری برازش شد. از این مدلها، باقیماندههای پیرسون (یعنی باقیماندهها تقسیم بر خطاهای استاندارد آنها) برای هر ژن بیان شده و نوع سلول محاسبه شد و در تجزیه و تحلیل QTL پاییندستی استفاده شد. استفاده از باقیماندههای پیرسون ۳.۹ تا ۱۰.۵% eGeneهای معنیدار در سراسر ژنوم بیشتری را نسبت به استفاده از باقیماندههای خام شناسایی کرد (شکل تکمیلی ۲۴).
.
در هر رده و زیررده سلولی، تجزیه و تحلیل eQTL برای واریانتهای در فاصله ۱ مگابایت از محل شروع رونویسی هر ژن بیان شده انجام شد. واریانتهای استنباط شده بر اساس کامل بودن ژنوتیپ (۹۵%)، فراوانی آلل جزئی (۱%) و معیارهای کیفیت استاندارد (INFO استنباط > ۰.۳) فیلتر شدند تا از آزمایش ارتباط با اطمینان بالا اطمینان حاصل شود. اهداکنندگان باید از کنترل کیفیت در هر دو مجموعه داده ژنوتیپ و بیان عبور میکردند. با توجه به تبار ژنتیکی متنوع افراد در این مجموعه داده، ما از یک مدل ترکیبی خطی برای در نظر گرفتن ساختار جمعیت و جلوگیری از یافتههای مثبت کاذب ناشی از سردرگمی ژنتیکی استفاده کردیم. ما این فرآیند را با استفاده از نرمافزار mmQTL (v1.5.0) برای مدلسازی یک ماتریس خویشاوندی ژنتیکی بین تمام جفتهای افراد به عنوان یک اثر تصادفی پیادهسازی کردیم. تجزیه و تحلیلهای Cis-eQTL منحصراً بر روی کروموزومهای اتوزومی انجام شد. واریانتها و ژنهای واقع در کروموزوم X حذف شدند. هر گروه به طور جداگانه تجزیه و تحلیل شد و نتایج eQTL با استفاده از یک فراتحلیل با اثرات ثابت ترکیب شدند.
.
تصحیح آزمونهای متعدد با استفاده از چارچوب کنترل FDR بنجامینی-هوچبرگ دو مرحلهای، همانطور که قبلاً انجام شده بود، صورت گرفت. ابتدا، برای هر ژن، تمام واریانتهای آزمایش شده در پنجره cis-با استفاده از روش بنجامینی-هوچبرگ برای کنترل FDR در میان واریانتهای آزمایش شده برای آن ژن تنظیم شدند. دوم، ما یک تصحیح بین ژنی را با اعمال روش بنجامینی-هوچبرگ در میان ژنها برای کنترل FDR در سراسر ژنوم اعمال کردیم.
تکرار در گروههای مستقل
برای گروه ROSMAP شامل ۴۲۴ اهداکننده و ۱.۵ میلیون هسته از DLPFC، شمارشهای خام snRNA-seq از مجموعه داده Fujita به دست آمد. تراز، کنترل کیفیت، حاشیهنویسی نوع سلول و تجزیه و تحلیل eQTL همانند دادههای PsychAD انجام شد. ترکیب نوع سلول مشابه گروه PsychAD است (شکل تکمیلی ۲۲).
.
مجموعه داده Bryois شامل سه گروه بود که ۱۹۲ اهداکننده و ۷۵۰,۰۰۰ هسته از قشر پیشپیشانی، قشر گیجگاهی و ماده سفید را در هشت نوع سلول حاشیهنویسی شده در بر میگرفت. آنها آمار خلاصه eQTL را ارائه کردند که ما در تجزیه و تحلیل تکرار خود از آنها استفاده کردیم.
ارزیابی تکرار واریانتهای تنظیمی ژنتیکی در میان مجموعههای داده
ما از بسته R qvalue برای تخمین نرخهای تکرار eQTL با استفاده از آمار p1 استوری (Storey’s p1 statistic) استفاده کردیم. برای یک جفت مجموعه داده، ابتدا مهمترین واریانت را برای ژنهایی با eQTL در دادههای کشف استخراج کردیم. سپس مقادیر P از مجموعه داده تکرار برای تخمین مقدار p1 استوری استفاده شد، که نشاندهنده کسری از آزمونهای فرضیه است که برای آنها فرضیه صفر رد میشود. بنابراین، p1 کسر تخمینی eQTLهایی است که در مجموعه داده دوم تکرار میشوند. این معیار تکرار مفید است زیرا به آستانههای سخت برای مقادیر P برای FDR وابسته نیست و به طور گستردهای پذیرفته شده است. گروه PsychAD از مطالعه حاضر برای کشف استفاده شد و نرخهای تکرار با استفاده از دادههای مستقل snRNA-seq از بافت مغز انسان پس از مرگ از مجموعههای داده Bryois و Fujita ارزیابی شد.
غنیسازی OCRها در اطراف واریانتهای تنظیمی شناسایی شده
برای تعیین اینکه آیا عناصر تنظیمی خاص نوع سلول در اطراف eQTLها غنی شدهاند، ما از تابع fdensity در QTLtools (v1.3.1) برای محاسبه تعداد عناصر عملکردی که هر bin ۱۰ کیلوبایتی را در یک پنجره ۲ مگابایتی در اطراف cis-eQTL همپوشانی میکنند، استفاده کردیم. حاشیهنویسیهای OCR از دادههای ATAC-seq تکسلولی از بافت مغز انسان به دست آمدند و OCRهای خاص نوع سلول به عنوان آنهایی تعریف شدند که فقط در یک نوع سلول یافت میشوند.
نقشهبرداری دقیق cis-eQTLها
ما نقشهبرداری دقیق را با CAVIAR (v.2.0.0) انجام دادیم که یک مدل احتمالی را برای تخمین احتمالات پسین گنجاندن در حالی که ساختار LD محلی مشتق شده از ژنوتیپهای مطالعه را در نظر میگیرد و یک واریانت علّی منفرد را فرض میکند، پیادهسازی میکند. ما سایر پارامترها را به مقادیر پیشفرض آنها تنظیم کردیم و واریانتها را از مجموعههای معتبر ۹۵% با رتبهبندی آنها بر اساس احتمال پسین گنجاندن تا زمانی که احتمال پسین تجمعی به ۰.۹۵ رسید، خروجی گرفتیم. ما توزیع اندازههای مجموعه معتبر را در میان جایگاهها گزارش میکنیم و یک خلاصه کمی از وضوح نقشهبرداری دقیق ارائه میدهیم.
تقسیم وراثتپذیری بر اساس نقشهبرداری دقیق آماری
از S-LDSC برای آزمایش اینکه آیا حاشیهنویسیهای واریانت سفارشی از نقشهبرداری دقیق آماری سیگنالهای eQTL برای وراثتپذیری قابل انتساب به خطر ژنتیکی برای ویژگیهای پیچیده غنی شدهاند، استفاده شد. تجزیه و تحلیلهای وراثتپذیری تقسیم شده فقط با استفاده از واریانتهای اتوزومی، مطابق با تجزیه و تحلیلهای استاندارد S-LDSC، انجام شد. برای هر eGene، از نقشهبرداری دقیق آماری برای محاسبه احتمال پسین گنجاندن برای هر واریانت cis-استفاده شد، و واریانتها در مجموعه معتبر ۹۵% برای هر ژن حفظ شدند. هر واریانت در ژنوم با یک مقدار احتمال از این تجزیه و تحلیل حاشیهنویسی میشود. واریانتهایی که در مجموعه معتبر ۹۵% نیستند، مقدار صفر دریافت میکنند، و واریانتهایی که برای چندین ژن ارزیابی میشوند، حداکثر مقدار احتمال را برای واریانت در میان این ژنها دریافت میکنند. این رویکرد در یک انتشار قبلی «MaxCPP» نامیده میشود. سپس از S-LDSC برای تقسیم وراثتپذیری ویژگی با استفاده از حاشیهنویسیهای عملکردی ساخته شده، با استفاده از پانل مرجع تبار اروپایی ۱۰۰۰ ژنوم فاز ۳ استفاده شد. غنیسازی تخمین زده شده برای اندازهگیری اهمیت هر رده eQTL برای ویژگیهای پیچیده انسانی یا بیماریها استفاده شد. برای رد تأثیرات بالقوه همبستگی در میان ردههای eQTL، ما مدل baselineLD را، که شامل مجموعهای از ۷۵ حاشیهنویسی عملکردی از یک انتشار قبلی است، برای ایجاد حاشیهنویسیهای عملکردی برای رده eQTL جمعآوری کردیم، سپس S-LDSC را به طور مشترک اجرا کردیم و معنیداری را با استفاده از مقدار P غنیسازی ارزیابی کردیم.
نسبت وراثتپذیری بیماری میانجیگری شده توسط واریانتهای تنظیمی
رگرسیون امتیاز بیان میانجیگری شده (MESC) نسبت وراثتپذیری بیماری را که توسط واریانتهای تنظیمی برای مجموعه خاصی از ویژگیهای مولکولی میانجیگری میشود، تخمین میزند. ما این رویکرد را برای تخمین سهم واریانتهای تنظیمی در ردهها و زیرردههای سلولی در وراثتپذیری ویژگیهای پیچیده به کار بردیم. سپس از MESC برای محاسبه وراثتپذیری میانجیگری شده با تنظیمات پیشفرض استفاده شد. برای تخمین سهم مشترک زیرتایپها از یک رده سلولی، ما همچنین MESC را با استفاده از meta_analyze_weights.py فراتحلیل کردیم. طبق دستورالعملهای بسته، تجزیه و تحلیل بر روی تمام ژنهای بیان شده انجام شد. هیچ فیلتر اضافی بر اساس نتایج cis-eQTL یا trans-eQTL، نقشهبرداری دقیق یا سایر معیارها انجام نشد.
همجایگزینی سیگنالهای ژنتیکی از واریانتهای تنظیمی و خطر بیماری
برای ارزیابی رابطه بین QTLهای مولکولی، ما از بسته R coloc برای انجام تجزیه و تحلیل همجایگزینی استفاده کردیم. نتایج خلاصه از فراتحلیل به عنوان ورودی برای coloc استفاده شد. همجایگزینی در مناطق همپوشانی بین eQTL و آمار خلاصه GWAS که در اطراف بدنه ژن متمرکز شده بودند، انجام شد. مطابق با کارهای قبلی گروه ما و دیگران، هیچ آستانه P ارزشی استفاده نشد، بنابراین امکان شناسایی همجایگزینی با یک جایگاه که به معنیداری در سراسر ژنوم نمیرسد، وجود دارد. واریانس فنوتیپی روی ۱ تنظیم شد زیرا ما نتایج خلاصه را قبل از فراتحلیل نرمالسازی کرده بودیم؛ در غیر این صورت، پارامترها به مقادیر پیشفرض خود تنظیم شدند. ما همچنین یک افزونه، moloc، را اعمال کردیم که این چارچوب را برای شناسایی همجایگزینی سه سیگنال به کار میبرد. برای تجزیه و تحلیلهای coloc، ما سیگنالهای بین دو ویژگی را با احتمال پسین = ۰.۸ (یعنی PP4 = ۰.۸) همجایگزینی در نظر گرفتیم.
شناسایی اثرات ژنتیکی تنظیمی مشترک و خاص نوع سلول
برای تعیین چگونگی اشتراک اثرات eQTL بین انواع سلولهای مختلف، ما یک رویکرد فراتحلیل بیزی چندمتغیره را با استفاده از نرمافزار mashr (v0.2.79) به کار بردیم. این نرمافزار از یک رویکرد بیزی برای کوچک کردن اندازههای اثر در میان ژنها و انواع سلولها برای تخمین اندازههای اثر پسین و احتمال پسین که یک اثر دارای علامت صحیح است، استفاده میکند. طبق دستورالعملهای mashr، ما توزیع اندازه اثر پیشین را با استفاده از مجموعهای از ژنهای بیان شده در تمام انواع سلولها تخمین زدیم و ساختار همبستگی تجربی را با استفاده از ۶۰۰,۰۰۰ جفت واریانت-ویژگی انتخاب شده تصادفی یاد گرفتیم. برای تمام ژنهایی با eQTL معنیدار در سراسر ژنوم در حداقل یک نوع سلول، واریانت با کوچکترین مقدار P انتخاب شد، و برآورد ضریب و خطای استاندارد در تجزیه و تحلیل با mashr استفاده شد. برای ژنهایی که در یک نوع سلول خاص به دلیل بیان ناکافی تجزیه و تحلیل نشدند، مقادیر صفر برای ضریب و ۱ × ۱۰۶ برای خطای استاندارد استفاده شد.
.
ما این رویکرد را برای توسعه یک آزمون آماری رسمی برای شناسایی اثرات تنظیمی ژنتیکی خاص نوع سلول گسترش میدهیم. اگرچه تجزیه و تحلیل mashr نتایج را در میان انواع سلولها ادغام میکند، نرمافزار اثر تنظیمی یک واریانت را در یک نوع سلول در یک زمان توصیف میکند. mashr آزمایش میکند که آیا یک اثر ژنتیکی در یک نوع سلول معین وجود دارد یا خیر. در مقابل، ما به طور مستقیم آزمایش میکنیم که آیا یک اثر ژنتیکی خاص نوع سلول است یا خیر، با استفاده از یک آزمون ترکیبی که ارزیابی میکند آیا اثر در یک نوع سلول معین غیرصفر است در حالی که در تمام انواع سلولهای دیگر نیز صفر است.
.
در اینجا، ما ریاضیات آزمون ترکیبی را توصیف میکنیم. برای یک ژن j و نوع سلول i، mashr نرخ علامت کاذب محلی را گزارش میکند که به صورت lfsrj,i = min[p(ßi,j = 0 | ß^,...), p(ßi,j = 0 | ß^,...)] تعریف میشود، که در آن (ßi,j = 0 | ß^,...) احتمال این است که مقدار واقعی ضریب رگرسیون با توجه به ضریب تخمین زده شده و سایر پارامترهای مدل، بزرگتر از صفر باشد. بنابراین، lfsri,j احتمال پسین است که علامت ضریب تخمین زده شده با علامت مقدار ضریب واقعی مطابقت ندارد، و محافظهکارانهتر از نرخ کشف کاذب محلی است. سپس اجازه دهید pi,j = 1 - lfsri,j احتمال مطابقت علائم باشد. برای یک ژن معین، این مجموعه از احتمالات پسین میتواند برای تخمین احتمال هر ترکیبی از اثرات eQTL در میان انواع سلولها استفاده شود. بنابراین، p1,j به عنوان یک تخمین محافظهکارانه از احتمال اینکه یک واریانت ژنتیکی دارای اندازه اثر غیرصفر در نوع سلول ۱ باشد، در نظر گرفته میشود، و 1 - p2,j به عنوان یک تخمین محافظهکارانه از اینکه اثر در نوع سلول ۲ صفر است، در نظر گرفته میشود. با ترکیب این تخمینها، احتمال یک اثر غیرصفر در نوع سلول ۱ و یک اثر صفر در نوع سلول ۲ برابر با p1,j(1 - p2,j) است، با فرض اینکه احتمالات مستقل هستند. به طور کلی، احتمال یک ترتیب با اثرات غیرصفر در مجموعه ۱ و تمام اثرات صفر در مجموعه ۲ برابر با [?i?set1 pi,j][?i?set2 (1 - pi,j)] است.
.
به دلیل قدرت آماری محدود برای تشخیص eQTLها در انواع سلولهای با وضوح بالا، اغلب بسیار محدودکننده است که بپرسیم، به عنوان مثال، آیا یک اثر eQTL در تمام زیرتایپهای نورون تحریکی غیرصفر است یا خیر. در عوض، میتوانیم بپرسیم که آیا یک اثر غیرصفر در حداقل یک زیرتایپ وجود دارد یا خیر، با ارزیابی 1 - [?i?set1 (1 - pi,j)].
تشخیص eQTL پویا مرتبط با پیری
به عنوان بخشی از کنسرسیوم PsychAD، تجزیه و تحلیلی از دینامیک رونویسی پیری طبیعی در طول عمر انسان در یک مقاله همراه انجام شد. با استفاده از مجموعه داده PsychAD، نویسندگان دادهها را از ۲۸۴ اهداکننده نوروتیپیک پس از مرگ با سن ۰ تا ۹۷ سال، شامل ۱.۳ میلیون هسته، استخراج کردند و اهداکنندگان را به شش گروه تکاملی تقسیم کردند: نوزادی (۰ تا ۱ سال، n = ۹)، کودکی (۲ تا ۱۱ سال، n = ۱۱)، نوجوانی (۱۲ تا ۱۹ سال، n = ۳۳) و بزرگسالی جوان (۲۰ تا ۳۹ سال، n = ۵۴)، میانسالی (۴۰ تا ۵۹ سال، n = ۹۵) و بزرگسالی دیررس (≥۶۰ سال، n = ۸۲). سپس نویسندگان یک مسیر شبهزمان را در هر نوع سلول، با استفاده از یک روش نظارت شده که سن اهداکننده را با اعمال روش UMAP of MATuration (UMAT) در بر میگرفت، ساختند. این رویکرد، پیشبینی را به یک فضای کمبعدی با محدود کردن انتخاب همسایه UMAP به هستههایی از مراحل تکاملی مجاور، محدود میکند. این محدودیت یک مسیر شبهزمان را تولید میکند که با ترتیب تکاملی شناخته شده اهداکنندگان بر اساس سن سازگار است. هستهها از مجموعه داده کامل PsychAD سپس به این فضای UMAT پیشبینی شدند و به هر هسته یک امتیاز شبهزمان مربوط به نوع سلول آن اختصاص داده شد.
.
سپس تجزیه و تحلیل QTL پویا در سطح تکهستهای برای هر نوع سلول با آزمایش اینکه آیا اثر ژنتیکی تخمین زده شده یک واریانت معین بر یک ویژگی بیان ژن در طول مسیر شبهزمان تغییر میکند، انجام شد. برای یک نوع سلول معین، هر هسته در یک مدل رگرسیون گنجانده شد که یک اثر تعاملی بین واریانت ژنتیکی و شبهزمان را آزمایش میکرد. دادههای شمارش خام برای بیان ژن با استفاده از یک مدل ترکیبی دوجملهای منفی (NBMM) تجزیه و تحلیل شدند، با اهداکننده به عنوان یک اثر تصادفی. ما دریافتیم که این NBMM برای کنترل نرخ مثبت کاذب در مجموعه داده ما حیاتی است. کوواریانسها برای اندازه کتابخانه، سن، جنسیت و نرخ میتوکندریایی به عنوان اثرات ثابت گنجانده شدند. تجزیه و تحلیلها با استفاده از تابع glmer.nb() در بسته lme4 R پیادهسازی شدند:
glmer.nb(y~pseudotime+SNP+pseudotime*SNP+covariates,…)
و مقادیر P از یک آزمون والد (Wald test) محاسبه شدند.
.
تجزیه و تحلیل NBMM در سطح تکهستهای بسیار پرتقاضا است و به دلیل تعداد زیاد هستههای گنجانده شده در هر تجزیه و تحلیل (آستروسیتها، ۷۶۳,۰۰۰؛ نورونهای تحریکی، ۱.۴۵ میلیون؛ سلولهای ایمنی، ۳۳۱,۰۰۰؛ نورونهای بازدارنده، ۹۷۳,۰۰۰؛ الیگودندروسیتها، ۲.۲۸ میلیون؛ و OPCs، ۳۶۳,۰۰۰) تقریباً ۱ ساعت زمان پردازش در هر رگرسیون نیاز دارد. با این حال، ما دریافتیم که این NBMM برای کنترل نرخ مثبت کاذب در مجموعه داده ما حیاتی است. به دلیل زمان محاسباتی بالا، ما رویکرد کار قبلی را دنبال کردیم و یک واریانت در هر ژن را برای هر نوع سلول تجزیه و تحلیل کردیم، واریانت برتر را از تجزیه و تحلیل استاندارد cis-eQTL شبهتودهای برای هر نوع سلول انتخاب کردیم.
.
غنیسازی ژنها با سیگنالهای تنظیمی پویا برای همجایگزینی با ویژگیهای بیماری به شرح زیر ارزیابی شد. برای یک رده سلولی i با di eGene پویا، تعداد ژنهایی که همچنین دارای یک سیگنال همجایگزینی بودند، محاسبه شد. توزیع صفر این شمارش با نمونهبرداری تصادفی di ژن و ارزیابی همپوشانی با ژنهایی با سیگنال همجایگزینی ارزیابی شد. خطای استاندارد همپوشانی برای هر نوع سلول با استفاده از ۱۰۰ دور نمونهبرداری تصادفی ارزیابی شد.
تشخیص Trans-eQTL
انجام تجزیه و تحلیل trans-eQTL بر روی تعداد زیادی از پلیمورفیسمهای تکنوکلئوتیدی (SNPs) از نظر محاسباتی گران است و بار آزمونهای متعدد قابل توجهی را به همراه دارد. طبق کارهای قبلی، ما هر دو این مسائل را با انتخاب واریانتهای اصلی، از جمله ۵۶,۲۰۴ eSNP از تجزیه و تحلیل cis-eQTL و ۴۵,۰۸۸ واریانت معنیدار در سراسر ژنوم از هشت مطالعه GWAS بیماری مغزی (یعنی واریانتهایی با P < ۵ × ۱۰-۸ در AD، اختلال پرخوری، اختلال دوقطبی، MDD، بیماری پارکینسون، SCZ، اختلال نقص توجه/بیشفعالی و اختلال طیف اوتیسم) حل کردیم. تجزیه و تحلیل بر روی تمام ژنهای بیان شده در هر رده سلولی انجام شد و به اتوزومها محدود شد، و کروموزوم X به دلیل پیچیدگی آماری و بیولوژیکی افزایش یافته مرتبط با مدلسازی اثرات تنظیمی دوربرد شامل کروموزومهای جنسی، حذف شد که منجر به ۸.۷۴ میلیارد آزمایش شد. ژنوتیپ SNP به عنوان متغیر وابسته در تمام جفتهای ژن-واریانت در مدل رگرسیون خطی که آزمایش کردیم، گنجانده شد. ما واریانتهای trans-را به عنوان واریانتهایی که بیش از ۵ مگابایت از ژنهای هدف فاصله داشتند، تعریف کردیم و بر روی کروموزومهای اتوزومی تمرکز کردیم، و هر سیگنال در مناطق اصلی سازگاری بافتی (MHC) را حذف کردیم. ژنهایی با امتیاز نقشهبرداری < ۰.۸ برای جلوگیری از یافتههای trans-eQTL مثبت کاذب ناشی از خوانشهایی که به چندین مکان در ژنوم نگاشت میشوند، حذف شدند.
.
ما تصحیح آزمونهای متعدد را در دو سطح طبق رویکرد روشهای پرکاربرد برای تجزیه و تحلیل cis-eQTL اعمال کردیم. برای یک ژن معین، واریانت اصلی eQTL به عنوان واریانت با کوچکترین مقدار P از تمام واریانتهای آزمایش شده برای آن ژن تعریف میشود. سایر برنامههای نرمافزاری از تجزیه و تحلیل جایگشت برای محاسبه مقادیر P در سطح ژن استفاده میکنند که این آزمونهای متعدد را تصحیح میکند. به جای انجام جایگشتهای پرهزینه محاسباتی، ما یک تصحیح Šidák را برای گزارش یک مقدار P در سطح ژن تصحیح شده برای آزمایش k واریانت، با استفاده از k = ۱ × ۱۰۵ اعمال کردیم. با فرض اینکه Pmin کوچکترین مقدار P مشاهده شده برای یک ژن معین باشد، مقدار P تصحیح شده Šidák برای ژن برابر با PSidak = 1 - (1 - Pmin)k است. با توجه به اینکه ما تجزیه و تحلیل trans-eQTL را برای شش رده سلولی انجام دادیم، مقادیر P در سطح ژن برای هر رده سلولی محاسبه شد. دور دوم تصحیح آزمونهای متعدد با استفاده از روش بنجامینی-هوچبرگ بر روی این مقادیر P در سطح ژن، در تمام ژنها و انواع سلولها اعمال شد. trans-eQTLهای معنیدار در سراسر مطالعه با FDR ۵% شناسایی شدند.
تجزیه و تحلیل میانجیگری trans-eQTLهای میانجیگری شده با cis
برای شناسایی trans-eQTLها با شواهد میانجیگری، ما اکتشاف خود را به trans-eSNPهایی با LD بالا (r۲ = ۰.۷۵) با حداقل یک واریانت eQTL اوج در فاصله ۱ مگابایت محدود کردیم. ما استراتژی توسعه یافته در یک انتشار قبلی را برای محاسبه تأثیر غیرمستقیم trans-SNPها بر trans-eGeneها اعمال کردیم. تصحیح آزمونهای متعدد با استفاده از رویکرد بنجامینی-هوچبرگ برای کنترل FDR در سراسر مطالعه در ۵% اعمال شد.
تجزیه و تحلیل کروموزوم X
ما تجزیه و تحلیل را بر روی کروموزوم X در سطح رده و زیررده طبق رویکرد استفاده شده توسط GTEx انجام دادیم. برای واریانتهای واقع در مناطق غیرشبهاتوزومی کروموزوم X، ما دوز ژنوتیپ خاص جنسیت را در نظر گرفتیم. با توجه به اینکه مردان برای کروموزوم X همیزیگوت هستند، ژنوتیپهای آنها به صورت ۰ (مرجع همیزیگوت) یا ۲ (آلترناتیو همیزیگوت) کدگذاری شدند که به طور مؤثر دوز آلل را دو برابر میکند تا با مقیاس دیپلوئید استفاده شده برای زنان مطابقت داشته باشد. ژنوتیپها در زنان همانند واریانتهای اتوزومی (۰، ۱ یا ۲) رفتار شدند. برای واریانتهای واقع در مناطق شبهاتوزومی کروموزوم X، ژنوتیپها به عنوان اتوزومی رفتار شدند زیرا این مناطق در هر دو کروموزوم X و Y وجود دارند و در هر دو جنس به صورت دیپلوئید عمل میکنند. سپس ما همان خط لوله تجزیه و تحلیل را برای کروموزومهای اتوزومی برای اجرای تشخیص eQTL اعمال کردیم. تجزیه و تحلیل در هر بانک مغز به طور جداگانه انجام شد و نتایج با استفاده از یک فراتحلیل با اثر ثابت ترکیب شدند. برآوردهای اندازه اثر سازگاری بالایی را در انواع سلولها نشان دادند، با نرخهای سازگاری علامت از ۸۴.۸% تا ۹۷.۸% (شکل تکمیلی ۲۶). این تجزیه و تحلیل بین هشت تا ۳۰۱ eGene را در سطح رده و بین یک تا ۲۱۳ eGene را در سطح زیررده آشکار کرد (شکل تکمیلی ۲۷).
در دسترس بودن دادهها
نتایج این تجزیه و تحلیل به صورت عمومی از https://www.synapse.org/Synapse:syn61929918/wiki/629719 در دسترس است. دادههای خام و پردازش شده در یک انتشار قبلی توصیف شدهاند و در https://www.synapse.org/Synapse:syn60084804/wiki/628473، با نیاز به تأیید، در دسترس هستند.
در دسترس بودن کد
تمام کدهای منبع استفاده شده در این مطالعه در https://github.com/DiseaseNeuroGenomics/nps_ad و https://doi.org/10.5281/zenodo.21226934 در دسترس هستند.